

- Leistungen
- Portfolio
- Referenzen
- Know-How
- Wir
Know-How, das Ihr Finance und Controlling stärkt
Kostenlose Webinare, E-Books, Experten-Beiträge und Live-Demos — praxisnah, aktuell und direkt einsetzbar.
Jetzt Know-How abrufen
- Karriere
- Kontakt
- Länder
Künstliche Intelligenz (KI) ist in vielen Unternehmen längst Teil des Arbeitsalltags. Mitarbeitende nutzen KI, um Texte zu strukturieren, Informationen zusammenzufassen, Ideen zu entwickeln oder wiederkehrende Aufgaben schneller zu erledigen. Häufig beginnt diese Nutzung jedoch nicht mit einer unternehmensweiten Strategie. Sie entsteht dezentral, aus einem konkreten Bedarf heraus und teilweise über private Zugänge zu öffentlich verfügbaren KI-Anwendungen.
Bei INSIRE verstehen wir den Einsatz generativer KI nicht als reine Einführung einzelner Tools, sondern als Teil einer übergreifenden KI-Strategie: Wir wollen Potenziale dort erschließen, wo KI im Arbeitsalltag konkreten Mehrwert schafft – sicher, verantwortungsvoll und praxisnah. Im Accounting beschäftigen wir uns mit möglichen Anwendungsfällen in Finance-Prozessen, etwa im Zusammenspiel mit SAP-Joule und weiteren KI-Werkzeugen. In Kundenprojekten und bei der internen Zusammenarbeit unterstützt unsere interne KI-Plattform, in welcher es im Folgenden geht, unsere Mitarbeitenden dabei, effizienter zu arbeiten und Wissen gezielter zu nutzen. Entscheidend ist dabei, Innovation mit den Anforderungen eines professionellen Unternehmensumfelds zu verbinden: Sobald Kundeninformationen, interne Dokumente oder vertrauliches Wissen ins Spiel kommen, müssen neben der Funktionalität auch Sicherheit, Datenschutz und klare Leitplanken berücksichtigt werden.
Wo werden eingegebene Daten verarbeitet? In welcher Region werden sie gespeichert? Werden Inhalte für das Training von Modellen verwendet? Welche Daten dürfen Mitarbeitende überhaupt eingeben? Wie lassen sich die Anforderungen aus Datenschutz (DSGVO), Informationssicherheit und dem EU AI Act berücksichtigen? Und wer übernimmt die Verantwortung für Regeln, Freigaben und die Weiterentwicklung der Nutzung?
Für uns war deshalb klar: Wir wollten KI nicht verbieten oder den Zugang unnötig erschweren. Wir wollten einen sicheren und zentralen Rahmen schaffen, in dem unsere Mitarbeitenden die Technologie produktiv nutzen können.
Der Einsatz generativer KI bringt Unternehmen in ein Spannungsfeld. Auf der einen Seite stehen Effizienz, Produktivität und eine spürbare Entlastung bei wiederkehrenden Aufgaben. Auf der anderen Seite stehen Datenschutz, Informationssicherheit, Governance und die Frage, wie sich eine neue Technologie kontrolliert in bestehende Prozesse integrieren lässt. Ein vollständiges Verbot privater KI-Anwendungen löst dieses Spannungsfeld meist nicht. Wenn Mitarbeitende den konkreten Nutzen bereits erlebt haben, besteht das Risiko, dass sie nicht freigegebene Lösungen trotzdem verwenden. Damit entsteht eine sogenannte Schattennutzung, die ein großes Risiko für Unternehmen bedeutet, kaum sichtbar und nur schwer steuerbar ist.
Gleichzeitig reicht es nicht aus, lediglich eine neue Plattform bereitzustellen. Ohne verständliche Leitlinien, klare Verantwortlichkeiten und konkrete Anwendungsfälle bleibt die Nutzung entweder gering oder entwickelt sich erneut unkoordiniert.
Unser Ziel war daher zweigeteilt. Wir wollten Risiken reduzieren und gleichzeitig das Potenzial von KI gezielt erschließen. Dazu brauchten wir einen Ansatz, der technische, organisatorische und menschliche Aspekte miteinander verbindet.
Der Handlungsdruck entsteht nicht nur durch neue technische Möglichkeiten. Die Nutzung von KI wächst schneller als die organisatorischen und rechtlichen Leitplanken vieler Unternehmen.
Der Cyberhaven AI Adoption and Risk Report 2025 zeigt die Größenordnung dieser Entwicklung. Die Häufigkeit der beruflichen KI-Nutzung stieg demnach innerhalb von zwölf Monaten um das 4,6-Fache und innerhalb von zwei Jahren um das 61-Fache. Gleichzeitig erhöhte sich der Anteil sensibler Unternehmensdaten an den in KI-Anwendungen eingegebenen Daten von 10,7 Prozent auf 34,8 Prozent. Zudem flossen 83,8 Prozent der analysierten Unternehmensdaten an Anwendungen, die Cyberhaven als mittel, hoch oder kritisch riskant einstufte. Die Untersuchung basiert auf Nutzungsmustern von rund sieben Millionen Beschäftigten. [^1]
Diese Zahlen bedeuten nicht, dass jede dritte KI-Nutzung automatisch rechtswidrig ist. Sie zeigen jedoch, wie schnell Produktivitätsgewinne mit Datenschutz, Informationssicherheit, Vertragsrisiken und dem Schutz geistigen Eigentums kollidieren können, wenn kein freigegebener Unternehmensrahmen besteht.
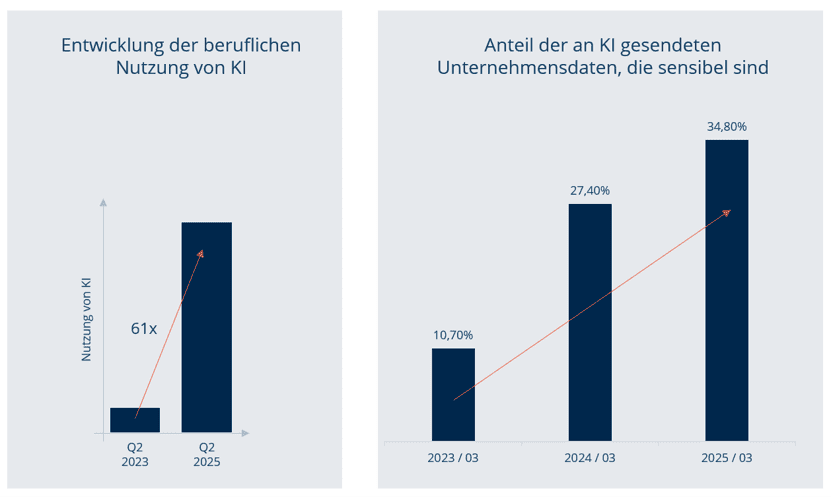
Berufliche KI-Nutzung und Datenrisiko: Visualisierung der Entwicklung von 2023 bis 2025 mit drei Kennzahlen: 61-fache Nutzung in zwei Jahren, Anstieg des Anteils sensibler Daten von 10,7 auf 34,8 Prozent sowie 83,8 Prozent Datenfluss zu mindestens mittelriskant eingestuften Tools
Ein Beispiel von Samsung macht das Risiko greifbar. Kurz nachdem Beschäftigte ChatGPT für ihre Arbeit nutzen durften, identifizierte das Unternehmen innerhalb weniger Wochen mindestens drei Fälle, in denen vertrauliche Informationen an den externen Dienst übermittelt worden waren. Dabei wurden fehlerhafter Quellcode zur Fehleranalyse, Programmcode zur Optimierung von Prüfabläufen und das Transkript einer internen Besprechung zur Erstellung eines Protokolls eingegeben. Wie Samsung die einzelnen Eingaben technisch entdeckte, wurde öffentlich nicht näher erläutert. [^2]
Problematisch war, dass damit geschütztes Know-how den kontrollierten Unternehmenskontext verließ und auf externen Servern verarbeitet wurde. Samsung verwies darauf, dass übermittelte Daten nur schwer zurückgerufen oder vollständig gelöscht werden könnten. Daraus entstanden Risiken für Geschäftsgeheimnisse, geistiges Eigentum und vertragliche Vertraulichkeit. Samsung begrenzte zunächst die Größe der Eingaben und schränkte die Nutzung generativer KI anschließend auf Unternehmensgeräten und in internen Netzen ein. Der Fall zeigt, was passieren kann, wenn ein nützliches Werkzeug schneller im Arbeitsalltag ankommt als Regeln, technische Schutzmaßnahmen und eine freigegebene Alternative. [^2]
Am Anfang stand für uns nicht die Auswahl eines bestimmten Tools. Zunächst haben wir betrachtet, welche Anforderungen sich aus unserem Arbeitsalltag ergeben und an welchen Stellen generative KI einen konkreten Nutzen schaffen kann.
Dabei standen mehrere Themen im Mittelpunkt:
Datenschutz und Datenverarbeitung
Wir mussten nachvollziehen können, wie Eingaben und hochgeladene Inhalte verarbeitet werden. Dazu gehörten insbesondere Fragen zur Datenresidenz, zu möglichen Trainingszwecken und zum Umgang mit vertraulichen Informationen. Eine technische Lösung muss in das Datenschutzkonzept des jeweiligen Unternehmens eingebettet werden. Sie ersetzt weder die rechtliche Bewertung noch die Definition zulässiger Nutzungsszenarien.
Zentraler und kontrollierter Zugang
Statt vieler privater Einzellizenzen wollten wir eine gemeinsame Enterprise Lösung bereitstellen. Mitarbeitende sollten über einen freigegebenen Zugang mit KI arbeiten können. Gleichzeitig sollte das Unternehmen in der Lage sein, Rollen, Modelle und Nutzungsmöglichkeiten kontrolliert bereitzustellen.
Praktische Anwendungsfälle
Die Einführung sollte nicht bei allgemeinen Experimenten stehen bleiben. Unternehmenswissen sollte sicher mit KI genutzt werden können und dort verfügbar sein, wo es heute bereits liegt. Über Integrationen zu Systemen wie SharePoint, Confluence, Jira oder Excel lassen sich vorhandene Informationen direkt einbinden. Das erleichtert Recherchen, fasst umfangreiche Inhalte zusammen und unterstützt bei Textentwürfen oder internen Fragen. Der eigentliche Mehrwert entsteht für uns dann, wenn KI nicht als Einzellösung danebensteht, sondern sinnvoll mit den bestehenden Wissensquellen und Arbeitsabläufen verbunden ist.
Austausch und Wiederverwendbarkeit
Gute Lösungen sollten nicht in einzelnen Teams oder persönlichen Zugängen verborgen bleiben. Unser Anspruch war, Erfahrungen, Anweisungen und entwickelte Assistenten im Unternehmen teilen und weiterentwickeln zu können. So entsteht aus individuellen Experimenten schrittweise ein gemeinsamer Wissensbestand.
Einfache Nutzung
Eine Plattform entfaltet nur dann Wirkung, wenn Mitarbeitende sie tatsächlich verwenden. Neben Sicherheit und Steuerbarkeit war deshalb auch die Benutzerfreundlichkeit entscheidend. Der Zugang zu KI sollte möglichst niedrigschwellig sein und sich an realen Aufgaben orientieren.
Von Anforderungen zur Toolentscheidung
Nach der Definition unserer Anforderungen haben wir nicht nur einzelne Sprachmodelle verglichen. Wir haben unterschiedliche Bereitstellungsmodelle und Enterprise Plattformen gegenübergestellt. Dazu gehörten je nach Betrachtungszeitpunkt unter anderem ChatGPT in verschiedenen Tarifen, Claude, Google Gemini, Microsoft 365 Copilot, MeinGPT, Notion AI und Langdock.
Ein solcher Vergleich ist anspruchsvoller, als Funktionslisten nebeneinanderzustellen. Ein Sprachmodell, eine in eine Office Suite integrierte Assistenz und eine modellagnostische Unternehmensplattform lösen unterschiedliche Probleme. Deshalb haben wir die Lösungen zunächst in Kategorien eingeordnet und anschließend gegen ein gemeinsames Zielbild bewertet.
Unser Bewertungsrahmen
| Dimension | Leitfragen |
| Lizenz und Skalierung | Welches Lizenzmodell gilt? Gibt es Mindestabnahmen oder Mindestnutzerzahlen? Welche Kosten entstehen bei beispielsweise 25 Nutzenden? Welche Funktionen sind nur in höheren Tarifen verfügbar? |
| Modelle und Flexibilität (Modellagnostizität) | Welche führenden Modelle stehen zur Verfügung? Kann das Unternehmen Modelle wechseln oder ist es langfristig an einen Anbieter gebunden? |
| Datenschutz und Verträge | Liegt ein belastbarer Auftragsverarbeitungsvertrag (AVV), vor? Werden Kundendaten für Trainingszwecke verwendet oder besteht ein vertraglich abgesicherter Trainings Opt Out? Welche Unterauftragnehmer sind beteiligt? |
| Datenresidenz und Verarbeitung | Wo liegen gespeicherte Daten? Wo findet die eigentliche Modellverarbeitung, also die Inferenz, statt? Werden Prompts, Dateien, Metadaten, Protokolle, Backups oder Supportdaten außerhalb des Europäischen Wirtschaftsraums verarbeitet? |
| Sicherheit | Wie werden Daten während der Übertragung und im Ruhezustand verschlüsselt? Welche Rollen, Zugriffskontrollen, Protokolle, Löschkonzepte und Administrationsmöglichkeiten stehen zur Verfügung? |
| Identitäten und Schlüssel | Lassen sich Single Sign On und Rollenmodelle integrieren? Werden Customer Managed Keys, Bring Your Own Key oder andere Formen kundenseitiger Schlüsselkontrolle angeboten? Können Zugriffe zentral widerrufen werden? |
| Schutz sensibler Daten | Gibt es Möglichkeiten zur Erkennung, Pseudonymisierung oder Maskierung personenbezogener Informationen, kurz PII, bevor Inhalte an ein Modell weitergegeben werden? |
| Integration | Wie gut fügt sich die Lösung in den bestehenden Technologie Stack ein? Gibt es Konnektoren etwa zu SharePoint oder anderen Wissensquellen und Unternehmensanwendungen? |
| Nutzungsspektrum | Werden Textzusammenfassung, Recherche, Dateiinteraktion, Code, Bilder, Assistenten, Agenten, Workflows und APIs unterstützt? |
| Governance und Betrieb | Können freigegebene Agenten, Richtlinien, Modellzugänge und Nutzungsoptionen zentral verwaltet und weiterentwickelt werden? |
| Adoption | Wie niedrig ist die Einstiegshürde? Welche Schulungsangebote, Hilfen und Möglichkeiten zum internen Teilen erfolgreicher Anwendungsfälle bestehen? |
Preise, Mindestabnahmen und Produktfunktionen verändern sich schnell. Deshalb sollte eine Anbieterbewertung immer mit Datum, Tarifstand und Quellen dokumentiert werden. Werte, die nicht vertraglich oder durch Anbieterunterlagen bestätigt sind, müssen als Annahme oder Schätzung gekennzeichnet werden. Das gilt besonders für Kostenmodelle bei einer bestimmten Nutzerzahl.
EU-Hosting allein reicht nicht aus
Ein zentraler Punkt unserer Evaluierung war die Abgrenzung von Datenresidenz und DSGVO Konformität. Ein Serverstandort in der EU ist ein wichtiger Baustein, aber kein automatischer Konformitätsnachweis.
Für eine belastbare Bewertung muss der gesamte Datenfluss betrachtet werden. Dazu zählen Speicherung, Modellinferenz, Protokollierung, Backups, Supportzugriffe, Unterauftragnehmer und mögliche Zugriffe aus Drittländern. Werden personenbezogene Daten an einen Empfänger außerhalb des Europäischen Wirtschaftsraums übertragen, greifen die Voraussetzungen des fünften Kapitels der DSGVO. Je nach Konstellation sind ein Angemessenheitsbeschluss oder geeignete Garantien erforderlich. Nach der Rechtsprechung und den Empfehlungen des Europäischen Datenschutzausschusses muss außerdem im Einzelfall geprüft werden, ob Recht und Praxis des Empfängerlandes die Wirksamkeit dieser Garantien beeinträchtigen. [^3]
Für die Praxis bedeutet das: Der Hinweis EU Hosting beantwortet zunächst nur einen Teil der Fragen. Unternehmen sollten mindestens prüfen:
Eine Plattform kann wesentliche technische und vertragliche Voraussetzungen bereitstellen. Die datenschutzrechtliche Zulässigkeit bleibt dennoch vom konkreten Einsatz, den verarbeiteten Daten und der Konfiguration des Unternehmens abhängig. Deshalb vermeiden wir pauschale Aussagen wie automatisch DSGVO konform.
Sicherheit besteht aus mehreren Ebenen
Bei der technischen Bewertung haben wir Sicherheit nicht auf den Speicherort reduziert. Ein tragfähiges Sicherheitskonzept betrachtet mehrere Ebenen:
Verschlüsselung bei Übertragung und Speicherung
Daten sollten sowohl während der Übertragung als auch im Ruhezustand geschützt sein. Bei der Bewertung einer Enterprise KI Lösung ist deshalb zu prüfen, welche Verschlüsselungsstandards eingesetzt werden, für welche Daten sie gelten und ob sie den gesamten Datenfluss abdecken.
Für die Übertragung sollte mindestens TLS 1.2 in sicherer Konfiguration, vorzugsweise TLS 1.3, eingesetzt werden. Veraltete SSL und TLS-Versionen sowie unsichere Cipher Suites müssen deaktiviert sein. Das BSI beschreibt die Anforderungen an Protokollversionen und kryptografische Verfahren in der Technischen Richtlinie BSI TR 02102 Teil 2. [^6]
Für gespeicherte Daten sollte ein etabliertes Verschlüsselungsverfahren wie AES 256 oder ein nach aktuellem Stand vergleichbar sicheres Verfahren verwendet werden. Der Schutz muss nicht nur Prompts und hochgeladene Dateien umfassen, sondern auch Ausgaben, Wissensbestände, Protokolle, temporäre Daten und Backups. AES 128, AES 192 und AES 256 werden in den aktuellen kryptografischen Empfehlungen des BSI berücksichtigt, wobei die konkrete Auswahl zum Schutzbedarf und zur Architektur passen muss. [^7]
Diese Angaben sollten im jeweiligen Auswahlprozess mit den aktuellen Anbieterunterlagen und der konkreten Bereitstellungsvariante abgeglichen werden.
Schlüsselkontrolle
Customer Managed Keys und Bring Your Own Key können Unternehmen zusätzliche Kontrolle über Verschlüsselungsschlüssel geben. Relevant sind dabei nicht nur Besitz und Erstellung des Schlüssels, sondern auch Rotation, Protokollierung und die Möglichkeit, den Zugriff zentral zu widerrufen. Solche Funktionen sind je nach Anbieter, Tarif und Architektur unterschiedlich verfügbar und müssen explizit verifiziert werden.
PII-Schutz vor der Modellverarbeitung
Die Erkennung und Maskierung personenbezogener Informationen vor der Weitergabe an ein Modell können das Risiko reduzieren. Sie ist jedoch kein Freifahrtschein. Qualität und Abdeckung der Erkennung, Fehlklassifikationen, verbleibende Metadaten und der Umgang mit nicht strukturierten Dokumenten müssen bewertet werden. Für sensible Anwendungsfälle kann zusätzlich eine organisatorische Pseudonymisierung vor dem Upload erforderlich sein.
Client Side Encryption und Zero Knowledge
Bei Client Side Encryption werden Inhalte verschlüsselt, bevor sie die kontrollierte Umgebung des Unternehmens verlassen. Zero Knowledge Architekturen zielen darauf, dass der Plattformanbieter keinen Zugriff auf unverschlüsselte Inhalte erhält. Das ist ein besonders hohes Schutzniveau, schränkt bei generativer KI aber Funktionen ein, sobald ein externes Modell Klartext zur Verarbeitung benötigt. Deshalb muss genau unterschieden werden, welche Daten für Speicherung, Suche und Modellinferenz tatsächlich verschlüsselt bleiben und welche Komponenten entschlüsseln können. Begriffe wie Zero Knowledge sollten nur verwendet werden, wenn Architektur und Anbieterunterlagen dies für den konkreten Datenpfad belegen.
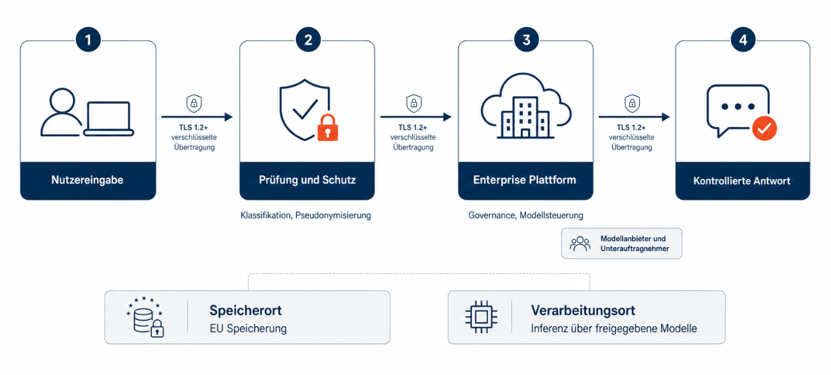
Datenfluss einer sicheren Enterprise KI Nutzung** Nutzereingabe, optionale Klassifikation und Pseudonymisierung, zentrale Enterprise Plattform, ausgewähltes Modell, verschlüsselte Übertragung, kontrollierte Rückgabe. Speicherort und Verarbeitungsort getrennt markieren. Modellanbieter und Unterauftragnehmer als eigene Ebene ausweisen.
Welche Fähigkeiten die Lösung abdecken sollte
Die Auswahl einer Unternehmenslösung hängt nicht nur von Chatfunktionen ab. Aus unserer praktischen Nutzung ergab sich ein breiteres Zielbild:
Nicht jede Funktion muss zum Start produktiv genutzt werden. Entscheidend ist, zwischen kurzfristig nutzbaren Standardfällen, kontrolliert zu pilotierenden Anwendungen und späteren Ausbaustufen zu unterscheiden.
Quelle [^1]: Cyberhaven, 2025 AI Adoption and Risk Report. Die Veröffentlichung nennt eine 4,6-fache Steigerung der Nutzung in zwölf Monaten, eine 61-fache Steigerung in 24 Monaten, 34,8 Prozent sensible Daten und 83,8 Prozent Datenfluss zu mindestens mittelriskant eingestuften Plattformen.
Quelle [^2]: CNBC, Samsung bans use of A.I. like ChatGPT for employees after misuse of the chatbot, 2. Mai 2023.
Quelle [^3]: European Data Protection Board, International data transfers sowie Empfehlungen zu zusätzlichen Maßnahmen für Übermittlungsinstrumente.
Quelle [^4]: Langdock, AI Security & Compliance. Laut Anbieter werden Daten während der Übertragung mit TLS 1.2 oder höher und im Ruhezustand mit AES 256 verschlüsselt.
Quelle [^5]: Langdock, Enterprise AI Platform und Enterprise AI API. Plattform und API
Quelle [^8]: BSI Bund, Technische Richtlinien

